Anatomie des Gedächtnisses: Wie Menschen und KI sich erinnern
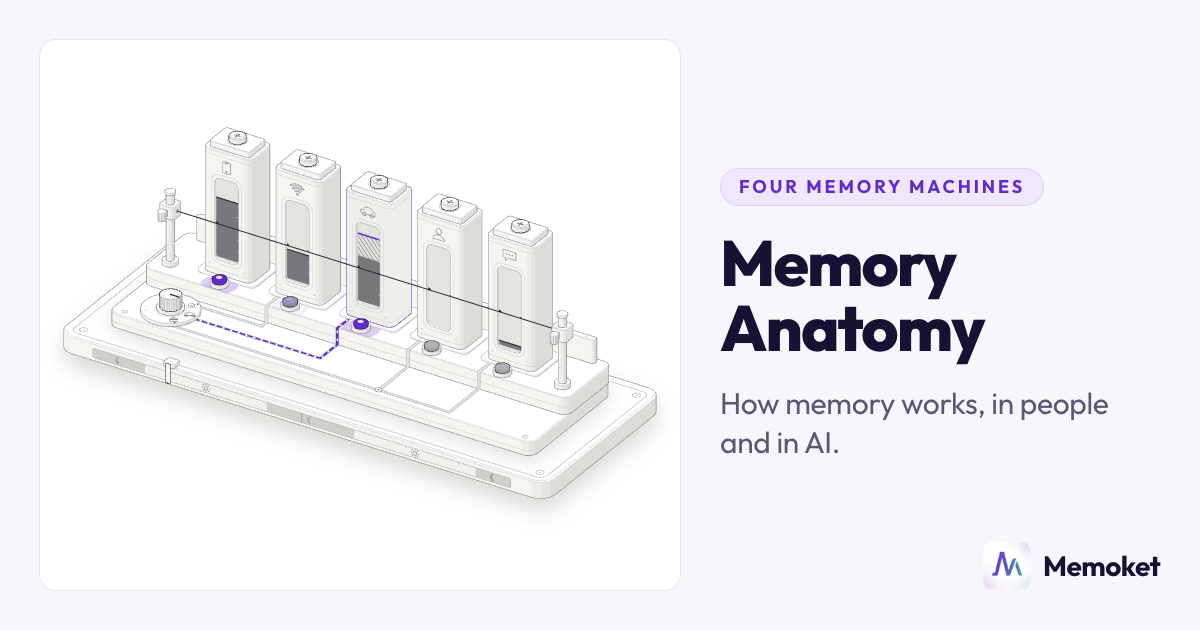
Jede der folgenden Maschinen stellt ein Gedächtnismodell dar. Sie zeigt dir zunächst selbstständig eine kurze Vorführung. Tippe sie an, um sie selbst auszuprobieren.
ACT-R
Warum dir manche Erinnerungen wieder einfallen und andere nicht
Auf Basis von ACT-R, einem Modell des menschlichen Denkens: Jede Erinnerung hat eine Stärke, die mit jedem Abruf wächst und langsam wieder abnimmt.
So funktioniert es
Hier siehst du das deklarative Gedächtnis von ACT-R, einem Modell des menschlichen Denkens von Carnegie Mellon. Die „Ladung“ in jedem Fenster ist die Aktivierung A einer Erinnerung. Die Autoren von ACT-R interpretieren sie als logarithmierte Odds dafür, dass die Erinnerung gebraucht wird (Taatgen, Lebiere und Anderson 2006). Die Fensterskala verläuft linear zu A, von −4 unten bis +3 oben.
Abrufe summieren sich und klingen ab: B = ln( Σ t_j^−d ). Jeder frühere Abruf j hinterlässt eine Spur, die gemäß t_j^−0.5 abklingt. Dabei ist t_j die seit diesem Abruf vergangene Zeit in Stunden; d = 0.5 ist der Standardwert von ACT-R (Anderson et al. 2004). Die Gleichung beruht auf dem Befund von Anderson und Schooler aus dem Jahr 1991: Die Odds dafür, etwas erneut zu brauchen, sinken als Potenz der Zeit, seit der es zuletzt gebraucht wurde. In unserer Rechnung halbiert sich eine Spur jedes Mal, wenn sich ihr Alter vervierfacht. Eine 1 Tag alte Spur ist also genau 10-mal stärker als eine 100 Tage alte: ein langer Ausläufer, der nie ganz null erreicht.
Dein Aufenthaltsort lädt nach: A = B + W (S − ln fan), mit einem Hinweisreiz im Fokus (W = 1) und S = 2 (Anderson et al. 2004). Das Zuhause und der Parkplatz sind jeweils mit einer Erinnerung verknüpft und steuern deshalb 2,0 bei. Der Arbeitsplatz ist mit zwei Erinnerungen verknüpft, die jeweils 1,31 erhalten: Ein Hinweisreiz, der auf mehr Erinnerungen verweist, ist eine schwächere Erinnerungshilfe. Das ist der Fan-Effekt. Der schraffierte Bereich im Fenster zeigt diese zusätzliche Ladung.
Nur oberhalb der Schwelle fällt dir die Erinnerung ein: Die Abrufwahrscheinlichkeit ist P = 1 / (1 + e^(−(A − τ)/s)), und die Helligkeit der Lampe entspricht P. Die dünne Linie und die Kerbe an jedem Fenster liegen bei τ = −1, mit dem Rauschparameter s = 0.4. Beide Werte dienen der Veranschaulichung: Laut den Autoren unterschied sich die Schwelle erheblich von Modell zu Modell, während s meist etwa 0,4 beträgt (Anderson et al. 2004). Die Anzeige übersetzt P in Worte: „fällt dir ein“ ab 90%, „wahrscheinlich“ ab 60%, „vielleicht“ ab 40%, „wahrscheinlich nicht“ ab 10% und darunter „gerade nicht abrufbar“.
Zur Veranschaulichung gewählt sind: die Vorgeschichte jeder Erinnerung (die Telefonnummer, die 90 Tage lang einmal täglich verwendet wurde; das WLAN-Passwort, das letzte Woche dreimal eingegeben wurde; der Kundenname, den du vor zwei Monaten einmal gehört hast), die Verknüpfungen zwischen Orten und Erinnerungen, Schwelle und Rauschparameter, Stunden als Zeiteinheit (eine andere Einheit verschiebt jede Ladung um denselben Betrag und damit lediglich die Schwelle), die Behandlung einer weniger als eine Stunde alten Spur als eine Stunde alt (bei einem Alter von null geht die Gleichung gegen unendlich) und das kurze Auffüllen beim Abruf eines Akkus (eine Drittelsekunde) oder beim Drehen des Reglers (etwas mehr als eine halbe Sekunde). Während der Vorführung läuft die Uhr bei Ereignissen langsam und in ruhigen Stunden schnell: pro Sekunde vergeht zwischen einer Fünftelstunde und zweieinhalb Stunden. Wenn du die Maschine selbst steuerst, sind es 1,5 Stunden pro Sekunde. Die Zeitleiste an der Vorderkante zeigt Montag und Dienstag. Die Nacht von 8 Uhr abends bis 6 Uhr morgens ist schattiert.
Grenzen: d = 0.5 ist ein Standardwert aus dem Labor, keine Naturkonstante. Anpassungen an Hashtag- und Musikdaten ergaben Abklingraten von 0,86 bis 1,74 (Kowald, Pujari und Lex 2017; Lex, Kowald und Schedl 2020; Reiter-Haas et al. 2021). Bei der Vorhersage des nächsten Hashtags einer Person lag eine einfache Sortierung nach der letzten Verwendung nur wenige Prozent von dieser Gleichung entfernt (Kowald, Pujari und Lex 2017). ACT-R bildet Vergessen als zeitlichen Abfall ab. Ob Zeit selbst das Vergessen verursacht, ist umstritten (Wixted 2004).
Quellen: Anderson und Schooler (1991), Reflections of the Environment in Memory, Psychological Science; Anderson, Bothell, Byrne, Douglass, Lebiere und Qin (2004), An Integrated Theory of the Mind, Psychological Review, S. 1042; Lewis und Vasishth (2005), Cognitive Science; Taatgen, Lebiere und Anderson (2006), Modeling Paradigms in ACT-R; Wixted (2004), Annual Review of Psychology.
Mehrspeichermodell
Wie du mehrere Dinge gleichzeitig im Kopf behältst
Auf Basis des Mehrspeichermodells, in dem Wahrgenommenes von einem flüchtigen ersten Eindruck ins Kurzzeit- und dann ins Langzeitgedächtnis gelangt, und des Arbeitsgedächtnisses – der kleinen Werkbank im Kopf.
So funktioniert es
Das Modell. Atkinson und Shiffrin (1968) teilten das Gedächtnis in ein sensorisches Register (den Eingangskorb), einen Kurzzeitspeicher (den Kartenständer) und einen Langzeitspeicher (das Regal) ein. Wiederholen ist eine bewusste Handlung: Es hält Inhalte im Kurzzeitspeicher und baut zugleich Langzeiterinnerungen auf, solange die Inhalte dort bleiben. Weitergeben heißt dabei Kopieren: Das Original bleibt zurück und verblasst in seinem eigenen Tempo. Baddeley und Hitch (1974) beschrieben den Kurzzeitspeicher als Arbeitsraum mit mehreren Teilen. In Baddeleys späterer Darstellung (2000) sind das eine zentrale Exekutive (Aufmerksamkeit, ohne eigenen Speicher: der Schalter), eine phonologische Schleife für Sprache (Kartenständer und Lampe), ein visuell-räumlicher Notizblock für Bilder (der Skizzenblock) und ein episodischer Puffer, der alles zu einer Szene verbindet (der Rahmen). In der Abbildung sind Baddeleys Komponenten Beschriftungen am selben Schreibtisch; sie bringen keine zusätzlichen Zahlen ins Modell.
- Eingangskorb (sensorisches Register). Verbleibende Tinte = e^(-t / 0.8 s) für ein gehörtes Wort und e^(-t / 0.15 s) für ein gesehenes Bild. Diese Abklingzeiten dienen der Veranschaulichung. Sie orientieren sich an Sperling (1960), bei dem etwa 9 von 12 Buchstaben kurz verfügbar waren und der zusätzliche Anteil innerhalb einer Sekunde verschwand, sowie an Darwin, Turvey und Crowder (1972), die einen auditiven Speicher mit einer Nutzungsdauer von etwa zwei Sekunden beschreiben.
- Kartenständer (Kurzzeitspeicher). 4 Plätze; kommt bei vollem Kartenständer ein neues Wort hinzu, wird eine zufällig ausgewählte Karte verdrängt. Das ist Atkinson und Shiffrins eigene Regel für Wortlisten. Dafür passten sie einen Puffer mit 4 Plätzen an die Daten an; bei einer anderen Aufgabe waren es 2. Die feste Größe betrachteten sie als Strategie, nicht als feste Eigenschaft des Gedächtnisses. Ohne Wiederholen: Tinte = e^(-t / 6 s). Diese Veranschaulichung wurde passend zu ihren „etwa 15 bis 30 Sekunden“ gewählt, sodass der Kartenständer nach etwa 18 s leer ist. Eine verdrängte Karte verblasst mit e^(-t / 1 s), ebenfalls eine Veranschaulichung ihres „sehr schnellen“ Verlusts. Fällt ihre Tintenstärke unter 5%, verlässt eine Karte den Kartenständer und wandert in den Ablagekorb. Auch diese Grenze ist zur Veranschaulichung gewählt.
- Regal (Langzeitspeicher). Jede Sekunde im Kartenständer erhöht die Stärke eines Wortes um 0,04 – den für Wortlisten angepassten Wert der Autoren. Der Füllstand seiner Regalkarte zeigt 1 - e^(-strength), die Wahrscheinlichkeit eines Abrufs aus dem Langzeitgedächtnis; zugleich wird die Schrift dunkler. Der Suchschritt beim Erinnern wurde weggelassen. Die Prozentwerte zeigen daher den Mechanismus und sind keine Vorhersage für reale Menschen. Wenn das Wiederholen ausgeschaltet ist, trägt eine verblassende Karte weiterhin 0,04 pro Sekunde mal ihrer Tintenstärke bei, bis sie den Kartenständer verlässt. Das ist unsere Erweiterung der Aussage der Autoren, dass die Übertragung weiterläuft, solange ein Inhalt im Kurzzeitspeicher liegt. In der Vorführung bleiben die ersten Wörter am längsten und am besten erhalten: Apfel 65%, Fluss 62%, Brot 50%, Schuh 44%, sieben 27%, Münze 11%.
- Skizzenblock. Das Bild liegt auf dem Skizzenblock, ohne einen Platz im Kartenständer zu belegen, weil die Schleife und der visuell-räumliche Notizblock getrennte Speicher sind (Baddeley 2000). In der Abbildung verblasst auch das Bild, wenn das Wiederholen ausgeschaltet wird, mit derselben 6-s-Kurve wie die Karten. Das dient dazu, den Schreibtisch einfach zu halten: In Baddeleys Modell frischt das innere Wiederholen von Wörtern den visuell-räumlichen Notizblock nicht auf.
- Wie viel kannst du im Kopf behalten? Miller (1956) fand bei vielen Arten von Material eine Spanne von etwa sieben Einheiten, gezählt in Chunks – inhaltlich zusammengehörigen Gruppen. Er vermutete, dass die Übereinstimmung bei sieben Zufall war; „plus oder minus zwei“ steht nur im Titel seiner Arbeit. Cowan (2001) fand bei Erwachsenen 3 bis 5 Chunks, wenn Wiederholen und Gruppieren verhindert werden. Sieben behielt er als reale Grenze für Material bei, das Menschen wiederholen und gruppieren können. Die vier Plätze des Kartenständers liegen innerhalb von Cowans Bereich, wurden aber für diese Zeichnung gewählt und sind keine gemessene Konstante.
- Verblassen oder Verdrängung? Ob Kurzzeiterinnerungen mit der Zeit verblassen oder durch neue Inhalte verdrängt werden, ist weiterhin umstritten. Berman, Jonides und Lewis (2009) fanden, dass Zeit allein wenig Vergessen verursacht und die Störung durch andere Inhalte mehr. In der Abbildung steht das Herausdrängen einer Karte für Verdrängung; das langsame Verblassen dient der Veranschaulichung.
- Die Lampe. Sie besucht die Karten im Ständer nacheinander, jeweils für 0,6 s. Dieses Tempo wurde gewählt, damit sich die Animation ruhig betrachten lässt; es beruht auf keinen Messdaten. Solange das Wiederholen eingeschaltet ist, bleibt die Schrift jeder Karte im Ständer vollständig erhalten – unabhängig davon, wo die Lampe gerade ist.
- KI. Das CoALA-Framework (Sumers et al. 2024) beschreibt, dass frühere Verfahren den eigenen Kontext des Sprachmodells als eine Form von Arbeitsgedächtnis verwendeten. MemGPT (Packer et al. 2023) behandelt den Kontext als Hauptspeicher fester Größe: Wird er voll, werden alte Nachrichten ausgelagert, in eine fortlaufende Zusammenfassung eingearbeitet und in einem durchsuchbaren externen Speicher aufbewahrt.
Quellen: Atkinson und Shiffrin 1968; Sperling 1960; Darwin, Turvey und Crowder 1972; Baddeley und Hitch 1974; Baddeley 2000; Miller 1956; Cowan 2001; Berman, Jonides und Lewis 2009; Sumers et al. 2024; Packer et al. 2023.
Komplementäre Lernsysteme
Warum das Gehirn in zwei Geschwindigkeiten lernt
Auf Basis komplementärer Lernsysteme: der Vorstellung, dass das Gehirn einzelne Erlebnisse schnell und allgemeines Wissen langsam lernt – und beide Systeme zusammenarbeiten.
So funktioniert es
Der Webstuhl ist ein kleines neuronales Netz, das David Rumelhart erstmals 1990 entwickelte. Du stellst eine Frage wie „Kann ein Rotkehlchen …?“ und es aktiviert Antwort-Einheiten mit Stärken von 0 (nein) bis 1 (ja). Das sind Antwortstärken, keine Wahrscheinlichkeiten. Jede Einheit berechnet a = 1 / (1 + e^-x) aus ihrer aufsummierten Eingabe. Nach jedem Fakt wird jede Verbindung ein kleines Stück in Richtung der richtigen Antwort angepasst: w = w + 0.1 × error × input (Backpropagation mit einer Lernrate von 0,1). Bevor die Abbildung startet, lernt der Webstuhl in 1.000 Durchgängen 32 Fakten über acht Pflanzen und Tiere, mit einem Aufbau wie bei McClelland (2013).
Beim Einpauken wird ausschließlich mit den zwei Pinguinfakten trainiert: Ein Pinguin ist ein Lebewesen, ein Tier und ein Vogel; er kann wachsen, sich bewegen und schwimmen. Beim Mischen kommen dieselben zwei Fakten in jeder Lektion zusammen mit allen 32 alten Fakten vor. Genau das leistet in der Theorie von McClelland, McNaughton und O'Reilly (1995) die Wiederholung aus dem Hippocampus. Beide Verfahren verwenden dieselbe Lernrate. Das Mischen erfordert deutlich mehr Übung: 200 Übungsdurchläufe beim Einpauken (2 Fakten in jeder von 100 Lektionen) gegenüber 3.400 beim Mischen (34 Fakten in jeder von 100 Lektionen), jeweils mit einem Trainingsschritt.
Was das Gewebe zeigt: In jeder Reihe füllen sich die sechs blauen Wellenfäden proportional zur Antwort des Webstuhls auf die Frage, ob das Tier schwimmen kann. Der Webstuhl beantwortet auch andere Fragen, etwa „Kann es fliegen?“, die im Gewebe nicht dargestellt sind. Die senkrechten Fäden stehen für die Verbindungen des Netzes, durch die alle Fragen zu jedem Tier laufen. Deshalb verändert das Üben mit einem Tier auch die Antworten für die anderen. Die Fäden neigen sich proportional zum Fehler des Webstuhls bei den alten Tieren (McClellands Maß von 2013 für Rotkehlchen, Kanarienvogel, Sonnenbarsch und Lachs): von keiner Neigung vor dem Lernen bis zur vollen Neigung nach 100 Einpauk-Lektionen. Wie weit das auf dem Bildschirm ist, haben wir für die Zeichnung festgelegt. Das Schwimmfeld eines Vogels erhält einen Umriss, sobald seine Antwort mindestens 0,08 über dem Ausgangswert liegt. Bei 0,2 ist der Umriss vollständig sichtbar; diese Grenzwerte haben wir gewählt. Das Lineal zählt die Lektionen.
Im Gewebe weggelassen sind die Pflanzenreihen, weil das Einpauken in unserem erneuten Durchlauf auch der Rose das „Schwimmen“ beibringt (von 0,05 auf 0,57), stärker als in der Arbeit von 1995 für Pflanzen beschrieben. Auch die Sonnenbarsch-Reihe fehlt; sie verhält sich ähnlich wie der Lachs (von 0,87 auf 0,98 beim Einpauken, 0,94 beim Mischen).
Die Zahlen. In der Arbeit von 1995 ließen 100 Einpauk-Lektionen den Fehler des Netzes bei alten „Kann“-Fakten von etwa 0,13 auf 0,67 steigen. Beim Mischen lag er nie über etwa 0,15 (von uns aus Abbildung 11 abgelesen). Die Zahlen auf dieser Karte stammen aus unserem eigenen erneuten Durchlauf desselben Tests (Seed 1). Sie dienen der Veranschaulichung und sind keine Daten aus der Veröffentlichung. Sie zeigen dasselbe Muster mit einem kleineren Effekt: „Kann ein Rotkehlchen schwimmen?“ steigt beim Einpauken von 0,04 auf 0,39 und endet beim Mischen bei 0,09. „Kann ein Kanarienvogel schwimmen?“ steigt beim Einpauken von 0,13 auf 0,59 und endet beim Mischen bei 0,21, nach einem leichten zwischenzeitlichen Anstieg auf 0,24. Einpauken bringt dem Netz den Pinguin schneller bei (0,90 gegenüber 0,70 nach 100 Lektionen). Über die Seeds 1 bis 10 erhöhte Einpauken den Fehler bei den alten Tieren auf das 1,8- bis 2,3-Fache; Mischen erhöhte ihn nie um mehr als 13%.
Zur Veranschaulichung gewählt sind: die Zeichnung nach einem Blick im Skizzenbuch und das einmalige Wiedereinspielen pro Lektion (auf dem Bildschirm hebt sich die Seite zweimal; im Modell kehrt der Pinguin in jeder der 100 Lektionen zurück. Die Autoren von 1995 nennen die tatsächliche Wiederholungshäufigkeit einer Erinnerung im Gehirn „völlig unbekannt“), die 100 Lektionen (passend zur Abbildung von 1995), die Bildschirmzeit (10 s für Einpauken und 16 s für Mischen, wobei die Lektionen als 100 u² ablaufen, damit die frühen Lektionen mit den größten Veränderungen mehr Zeit erhalten) und der Weg des Webschiffchens. Auf einem echten Webstuhl kann nur die neueste Reihe gewebt werden. Beim Mischen stehen die Besuche des Schiffchens in alten Reihen deshalb dafür, sie wieder zu spannen: Fakten zu üben, die der Webstuhl schon kennt. Das ist keine Behauptung, dass das Gehirn durch Backpropagation lernt; die Autoren von 1995 bezeichnen diese Modelle als Veranschaulichungen auf einer abstrakten Ebene.
Seit 2016 schließt die Theorie ein, dass der Neokortex schnell lernen kann, wenn eine neue Information zu seinem Vorwissen passt – etwa ein neuer Fisch, der schwimmt, oder ein neuer Vogel, der fliegt. Beim Pinguin geht es langsam, weil er das Vogelmuster durchbricht (Kumaran, Hassabis und McClelland 2016; McClelland 2013). Der beim Einpauken sichtbare Schaden heißt katastrophale Interferenz und wurde erstmals von McCloskey und Cohen (1989) beschrieben.
Für KI teilt die Retrieval-Arbeit von Lewis et al. (2020) das Gedächtnis eines Sprachmodells in trainierte Gewichte und einen durchsuchbaren Dokumentenindex auf. Durch Austausch des Index konnte sie die Antworten des Modells über Staats- und Regierungschefs aktualisieren, ohne es neu zu trainieren. Der Vergleich dieses Index mit dem Skizzenbuch ist unsere Analogie, nicht die der Veröffentlichung. Beim Fine-Tuning von Sprachmodellen auf aufeinanderfolgende Aufgaben wurde beobachtet, dass frühere Aufgaben vergessen werden (Luo et al. 2023). Schon das erneute Beimischen einer kleinen Menge alter Trainingsdaten verringert dieses Vergessen (Ibrahim et al. 2024).
Quellen: McClelland, McNaughton und O'Reilly (1995), Why There Are Complementary Learning Systems in the Hippocampus and Neocortex, Psychological Review 102, S. 433–435 und 442; McClelland (2013), Incorporating Rapid Neocortical Learning of New Schema-Consistent Information Into Complementary Learning Systems Theory, Journal of Experimental Psychology: General 142; Kumaran, Hassabis und McClelland (2016), What Learning Systems do Intelligent Agents Need?, Trends in Cognitive Sciences 20; McCloskey und Cohen (1989), Catastrophic Interference in Connectionist Networks, Psychology of Learning and Motivation 24; Lewis et al. (2020), Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks; Luo et al. (2023), An Empirical Study of Catastrophic Forgetting in Large Language Models During Continual Fine-tuning; Ibrahim et al. (2024), Simple and Scalable Strategies to Continually Pre-train Large Language Models.
Das Gedächtnis im KI-Chat
Wie ein Chatbot den Überblick über ein langes Gespräch behält
Auf Basis der Gedächtnisverwaltung vieler KI-Chatsysteme: Ein Kontextfenster enthält den Text, den das Modell auf einmal lesen kann. Dazu kommen Zusammenfassungen und ein durchsuchbarer Speicher alter Nachrichten.
So funktioniert es
Der Kartenständer fasst 70 Tokens: die festen Anweisungen (8 Tokens), die Notiz und die Nachrichtenkarten. Ein Token ist ein Wort oder ein Wortteil. Die Breite jeder Karte ergibt sich aus ihrer Textlänge, geteilt durch 3,5 Zeichen pro Token – eine Schätzung von Anthropic für seine früheren Modelle. 70 ist eine Spielzeuggröße: Reale Kontextfenster fassten Anfang 2024 zwischen 2.000 und 200.000 Tokens (Packer et al. 2023), 2026 bis zu 1.000.000 (Anthropic). Hier werden nur deine Nachrichten als Karten dargestellt. Ein echtes Kontextfenster enthält auch die Antworten des Chatbots und alle Werkzeugausgaben.
Über 70 Prozent meldet die Anzeige „fast voll“. Würde eine neue Karte 100 Prozent überschreiten, wartet sie im Drucker, während die ältesten Karten – etwa die Hälfte des Ständers – in die Box wandern. Aus der bisherigen Notiz und diesen Karten wird eine neue Notiz geschrieben. Das folgt dem Forschungssystem MemGPT (Packer et al. 2023), das alte Nachrichten in einem Speicher und eine fortlaufende Zusammenfassung im Kontextfenster hält. Die Werte 70, 100 und 50 Prozent sind dessen Beispiele, keine Standardeinstellungen. Das Modell tut das nicht von selbst: Ist der Text zu lang, wird die Anfrage abgewiesen. Deshalb schafft die Software um das Modell herum Platz.
Die Notiz bietet Platz für 23 Tokens; das dient der Veranschaulichung. Wird sie zu lang, streicht die Abbildung zuerst das älteste Detail und fasst dann Zeilen zum selben Thema zusammen. Diese einfache Regel kann ein Detail verwerfen, obwohl es noch hineingepasst hätte: In der zweiten Notiz verschwinden die Erdnüsse, obwohl „Allergisch gegen Erdnüsse.“ nicht länger ist als „Hat eine Nahrungsmittelallergie.“ Eine echte Notiz wird von einem Sprachmodell geschrieben, das anders auswählt. Eine aus einer Notiz erstellte neue Notiz kann noch mehr verlieren. Der gemessene Verlust schwankt stark: Bei einer manuellen Prüfung war in etwa 4 Prozent des Inhalts der Zusammenfassungen ein Detail verloren gegangen (Wang et al. 2023). In MemGPTs Gedächtnistest, der gezielt Details aus alten Chats erforderte, beantworteten Modelle mit bloßem Zugriff auf eine Zusammenfassung 32 bis 39 Prozent der Fragen. Mit durchsuchbarem vollständigem Verlauf waren es 67 bis 93 Prozent.
Die Suche: Die Frage und jede Karte werden in Zahlenlisten (Embeddings) umgewandelt, die inhaltlich verwandte Texte nahe beieinander verorten. Dabei gilt similarity = cos θ = Σ qᵢnᵢ / (|q| |n|); 1 bedeutet, dass die Listen in dieselbe Richtung zeigen. Jede Karte in der Box hebt sich proportional zu ihrer Ähnlichkeit. Die 2 besten Karten mit einem Wert ab 0,5 kehren als Kopien mit Büroklammer zurück. Das Original bleibt in der Box; wird eine Kopie wieder verdrängt, kehrt sie einfach dorthin zurück. Unsere Listen enthalten 16 von Hand gesetzte Zahlen; reale Listen haben 768 bis 3.072 erlernte Zahlen (Karpukhin et al. 2020; OpenAI). Ähnlich heißt nicht richtig: Die Oktopus-Karte erreicht bei der Filmfrage 0,78, nahe an den 0,80 der Filmkarte, und kommt deshalb ebenfalls zurück.
Zur Veranschaulichung gewählt, nicht gemessen: der Kartenständer mit 70 Tokens, die Notiz mit 23 Tokens, die Regel, zuerst die ältesten Details zu streichen, die 2 Karten, die Untergrenze von 0,5 und die von Hand gesetzten Embeddings. Veröffentlicht sind: 3,5 Zeichen pro Token, die Beispiele mit 70, 100 und 50 Prozent, die Kontextfenstergrößen und die oben genannten Verlustwerte. Vereinfacht ist: Zu jeder Frage wird gesucht und alte Karten bleiben in der Box, obwohl viele Apps sie einfach verwerfen.
Quellen: Packer et al. 2023 (MemGPT); Lewis et al. 2020 (Retrieval-Augmented Generation); Karpukhin et al. 2020 (Dense Retrieval); Wang et al. 2023 (rekursive Zusammenfassungen); Anthropic 2025 und 2026 (Kontextfenster, Kontextverdichtung, Glossar); OpenAI (Embedding-Leitfaden).
Die Maschinen folgen veröffentlichten Gedächtnismodellen. Welche Zahlen dahinterstehen und woher sie stammen, findest du jeweils unter „So funktioniert es“.
Möchtest du das für deine eigenen Agenten nutzen? KITE ist unsere quelloffene Gedächtnis-Engine.
Gib KITE einen Stern auf GitHubOder verbinde Memoket mit ChatGPT, Claude oder einem Agenten

